go4you – Aufgaben, Ziele und Wissen in einem System: Privacy-First statt Tool-Zoo
Selbst gebaut, produktiv im Einsatz – kein anonymisiertes Beispiel. Geprüft am 5. August 2026.
- Aufgabentyp
- Wissen
- Betrieb
- Hybrid
- Aufwand
- Groß
- Zeitrahmen
- Iterativ über mehrere Monate (agentic coding)
- Quelle
- Eigenes Projekt, täglich produktiv im Einsatz (Web + iOS)
Aufgabe
Der typische Produktivitäts-Stack ist fragmentiert: Todoist für Aufgaben, Notion fürs Wissen, Obsidian als Zettelkasten, Google Kalender für Termine – vier US-Clouds, keine gemeinsame Suche, keine Verbindung zwischen Tagesplan und Langfrist-Zielen. Gesucht: ein System, das Aufgaben an Ziele koppelt, Wissen verlinkt statt ablegt – und die Daten in der EU hält.
Lösungsweg
Selbst entwickelte PWA + native iOS-App auf Supabase (Frankfurt) mit Row-Level-Security. Wissens-Vault mit Wikilinks, Backlinks und Graph-Ansicht, per WebDAV bidirektional auf das eigene NAS gespiegelt (Obsidian-kompatibel). KI-Ingest analysiert URLs und Dateien und legt typisierte, verlinkte Notizen an. Ein eigener MCP-Server macht das System für KI-Agenten (Claude) durchsuch- und steuerbar. Agenten-Inbox schlägt Aktionen vor – mit einstellbarer Autonomie von 'fragen' bis 'automatisch'.
Kontrollpunkt Ein Mensch prüft oder gibt das Ergebnis frei.
Autonomiestufe 2 von 4 Notizen legt der KI-Ingest selbst an und verlinkt sie. Für Aktionen der Agenten-Inbox ist die Autonomie einstellbar, von „fragen“ bis „automatisch“; die Stufe ist hier also buchstäblich eine Einstellung. Was die fünf Stufen bedeuten
Vorher und Nachher
Die Veränderung wird als Arbeitsablauf beschrieben, nicht als Erfolgsversprechen.
Vorher
- Wissen in vier Silos ohne gemeinsame Suche
- Tagesaufgaben ohne Bezug zu Zielen
- US-Cloud-Abos mit unklarer Datenlage
Nachher
- Wikilinks + Backlinks + Volltextsuche über Notizen, PDFs, Aufgaben
- Jede Aufgabe sichtbar an Lebensbereich/Ziel gekoppelt
- BYO-API-Key für KI: Schlüssel bleibt im Browser, Anbieter frei wählbar (auch EU)
Dokumentierte Ergebniswerte
Die Werte gelten im jeweils beschriebenen Szenario und sind kein allgemeiner Benchmark.
- System ersetzt Todoist + Notion + Obsidian + Sync-Gebastel
- 1 statt 4
- Datenhaltung: Frankfurt + WebDAV-Spiegel, kein Tracking
- EU/eigenes NAS
- agentenfähig: Notizen, Aufgaben, Ziele, Kalender per Agent steuerbar
- 20 MCP-Tools
Herleitung: vom Prozess zum Werkzeug
Das Setup folgt aus der Tätigkeit und ihren Daten, nicht aus einer Tool-Präferenz. Die Kette läuft immer in dieselbe Richtung.
-
Tätigkeit
Persönliche Aufgaben, Ziele und Notizen erfassen, verknüpfen und durchsuchen
-
Datenfluss
- Personenbezogen Eigene Notizen, Aufgaben, Ziele, Gewohnheiten, Termine
-
Werkzeugklasse
Klasse 3 EU-Hosting mit AVV
-
Setup
Die eigenen Lebens- und Arbeitsdaten sind durchgehend personenbezogen; Datenhaltung in Frankfurt mit Row-Level-Security plus NAS-Spiegel erfüllt die Mindestklasse. Die LLM-Anbindung läuft per eigenem Schlüssel, mit einem EU-Anbieter wie Mistral bleibt auch der KI-Anteil in Klasse 3.
Die Werkzeugklasse ist die Mindestanforderung für die Daten, die tatsächlich ins Werkzeug fließen. Wie die Kette Nutzenrechnung, Rechtsfrage und Werkzeugwahl aus derselben Tabelle beantwortet, steht unter Prozessanalyse & Werkzeugwahl.
Werkzeug-Stack
Das eigentliche Problem: Tool-Zoo
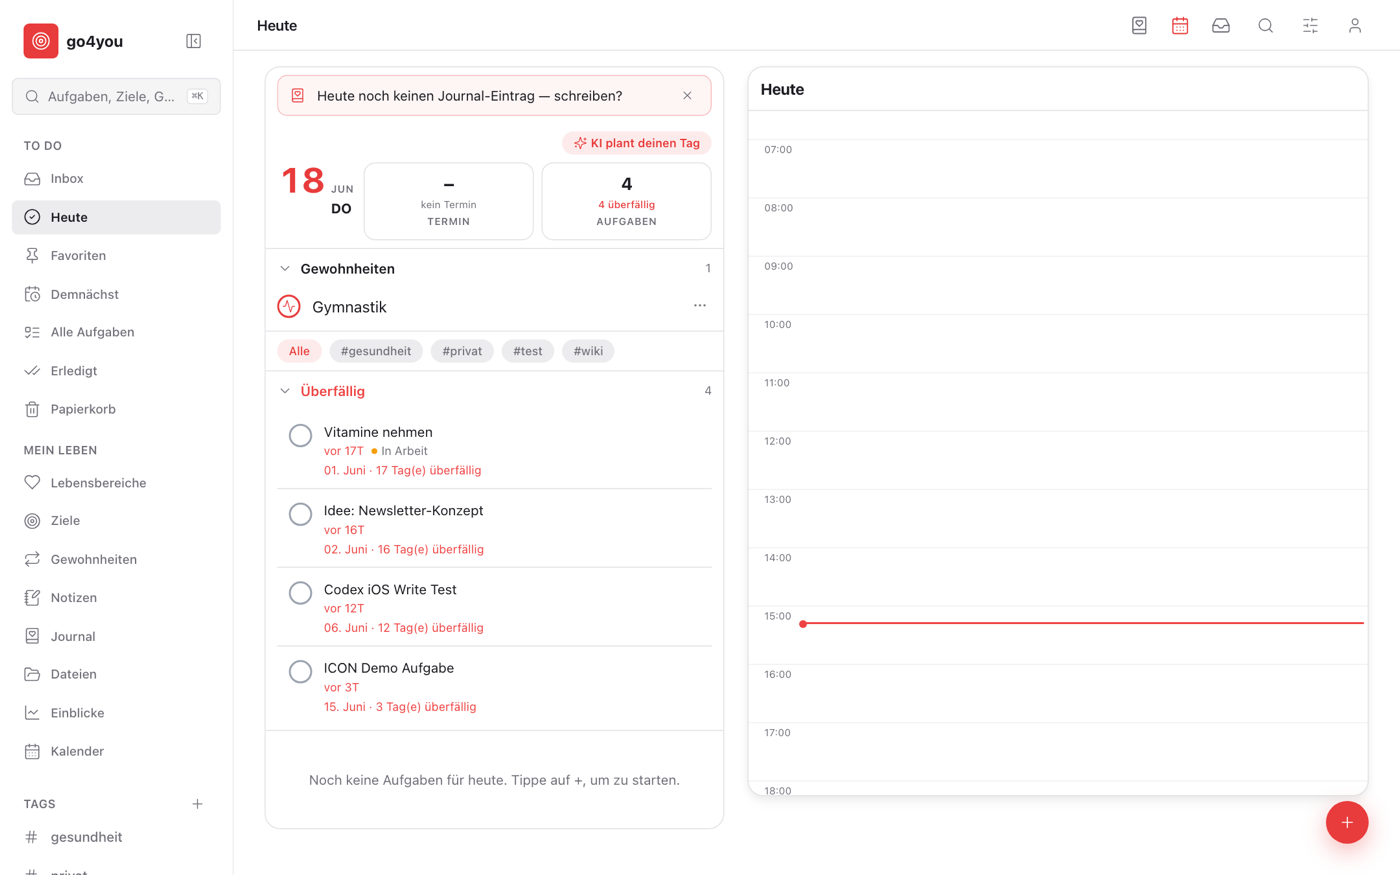
Vier Systeme, null Verbindung: Aufgaben in Todoist, Wissen in Notion, Zettelkasten in Obsidian, Termine in Google Kalender. Keine gemeinsame Suche, kein Bezug zwischen dem, was heute ansteht, und dem, was langfristig zählt. Der Leitgedanke beim Bau war „Purpose First“ – jede Aufgabe hängt sichtbar an einem Ziel, jedes Ziel an einem Lebensbereich. Kein Tagesplan ohne Kontext, wozu er eigentlich dient.
Wissensmanagement im Kern
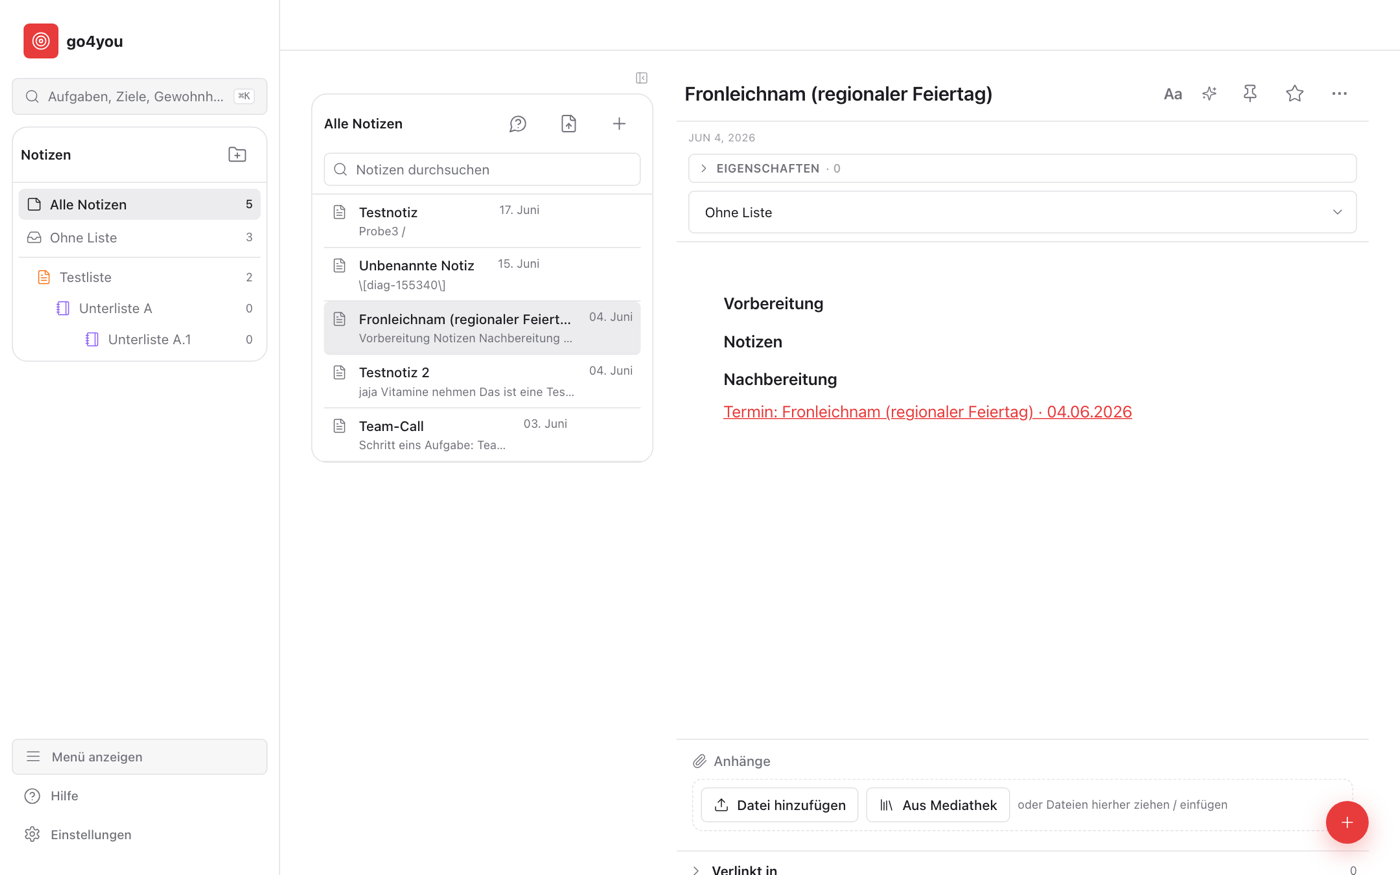
Notizen verlinken sich per Wikilink, Backlinks laufen automatisch mit, eine Graph-Ansicht macht Zusammenhänge sichtbar. Dazu kommt KI-Ingest: URL oder Datei rein – die KI erkennt den Typ, extrahiert Quelle und Kernkonzepte und legt eine verlinkte Notiz an, ganz ohne manuelles Tagging. Volltextsuche schließt PDF-Inhalte ein, eine KI-Chat-Suche liefert Antworten mit Deep-Links zur Quelle.
Der Obsidian-Brückenschlag
Ein bidirektionaler WebDAV-Spiegel hält Notizen als Markdown auf dem eigenen NAS, editierbar in Obsidian, synchron mit der App. Datenhoheit ist damit kein Feature-Versprechen im Marketing-Sinn, sondern Dateisystem-Realität: Die Daten liegen im eigenen Netz, in einem offenen Format, jederzeit lesbar ohne die App.
Agentenfähig per MCP
Ein eigener MCP-Server macht das System für KI-Agenten steuerbar – 20 Tools decken
Aufgaben, Notizen, Ziele, Gewohnheiten und Kalender ab, von create_task über
search_notes bis today_agenda. Claude kann damit Aufgaben anlegen, Notizen
verlinken oder die Tagesagenda ziehen. Der Anschluss an das größere Thema
Agentic Coding & KI in der Softwareentwicklung ist
kein Zufall – das MCP-Muster ist dasselbe, das agentenfähige Software für Unternehmen
ausmacht.
DSGVO-bewusst, nicht DSGVO-Etikett
EU-Hosting (Frankfurt), Row-Level-Security auf Datenbankebene, kein Tracking, keine Telemetrie, Datenexport nach Excel oder Markdown eingebaut. KI-Anbindung nach dem Bring-your-own-Key-Prinzip: Der Schlüssel bleibt im Browser, das System diktiert keinen Anbieter – ein EU-Anbieter (Mistral) ist wählbar. Ehrlich dazu gehört die Kehrseite: Je nach gewähltem LLM-Anbieter läuft ein Teil der Anfragen über US-APIs, und die Frontend-Auslieferung läuft über Cloudflare/Hostinger. „Vollständig DSGVO-konform“ oder „komplett self-hosted“ wäre deshalb übertrieben – „DSGVO-bewusst konstruiert: Daten in der EU, KI-Zugriff unter eigener Kontrolle, und Klartext darüber, welcher Baustein wohin telefoniert“ trifft es genauer. Ebenso bewusst: RAG mit Vektorsuche ist zurückgestellt, nicht weil es schwer wäre, sondern weil der eigene Notiz-Korpus schlicht noch zu klein für ein echtes Retrieval-Problem ist – pgvector ist vorbereitet, wird aber erst aktiviert, wenn der Korpus das rechtfertigt.
Was KMU daraus mitnehmen
Dasselbe Muster – kuratiertes Wissen, Volltextsuche, Agenten-Zugriff über eine definierte Schnittstelle – ist der Unterbau von Mitarbeiter-Chat auf eigenem Wissen und dem RAG-Chat auf dieser Website. Der Unterschied ist nur der Maßstab: hier ein persönliches System, dort ein Team- oder Unternehmens-Wissensspeicher – die Architektur-Entscheidungen sind dieselben.